Sensordaten mit Peakboard Hub Flows aggregieren und archivieren
Mit Peakboard Hub Flows kannst du große Mengen Sensordaten im Peakboard Hub automatisch verdichten und archivieren: Ein Hub Flow berechnet täglich die Tageswerte, ein zweiter verschiebt ältere Rohdaten in eine Archivliste.
04.11.2026
·
5 Min. Lesezeit

- Ein Hub Flow kann Rohdaten vorab aggregieren, damit alle Anwendungen dieselben Tageswerte nutzen können.
- Im Beispiel entstehen täglich um 23:00 Uhr Minimum, Maximum und Durchschnitt der Temperatur in der Hub-Liste TemperatureDaily.
- Ein zweiter Hub Flow verschiebt um 23:15 Uhr Rohdaten, die älter als 7 Tage sind, in eine Archivliste.
- So bleibt die Tabelle mit den Rohdaten klein, und die älteren Daten stehen weiterhin zur Verfügung.
Das Beispiel zeigt beide Muster mit den Daten eines Temperatursensors.
Warum Rohdaten verdichten und archivieren
Maschinen und Sensoren in Lager und Werk erzeugen laufend große Datenmengen. Peakboard-Anwendungen nutzen diese Daten, um sie zu visualisieren, Auswertungen zu zeigen oder bei auffälligen Werten zu benachrichtigen.
Daten vorab aggregieren
Oft genügen den Anwendungen verdichtete Werte. Eine Anwendung soll zum Beispiel Minimum, Maximum und Durchschnitt der Temperatur der letzten 7 Tage zeigen, der Sensor liefert aber alle 6 Minuten einen neuen Wert. Nutzen mehrere Anwendungen dieselben Daten, müsste jede selbst aggregieren. Einfacher ist es, die Daten einmal vorab zu aggregieren und allen Anwendungen bereitzustellen.
Ältere Daten archivieren
Mit der Zeit werden die Tabellen mit Rohdaten sehr groß, und Abfragen werden langsamer, vor allem wenn mehrere Anwendungen mehrmals am Tag darauf zugreifen. Damit die Rohdatentabelle klein bleibt und die älteren Daten trotzdem verfügbar sind, kann ein Hub Flow Daten, die älter als 7 Tage sind, aus der Rohdatentabelle in eine Archivtabelle verschieben.
Die Ausgangsdaten
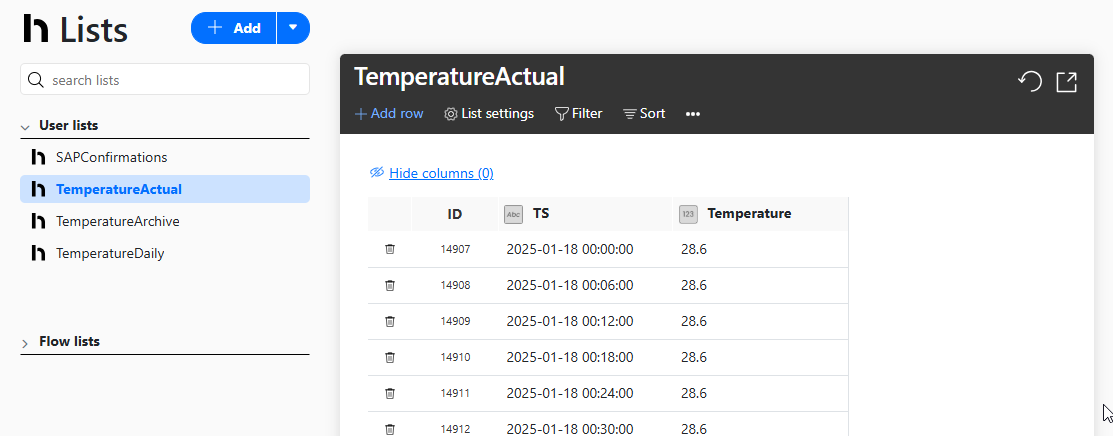
Die Rohdaten stehen in der Hub-Liste TemperatureActual. Alle 6 Minuten kommt eine neue Zeile dazu: Die Spalte TS enthält den Zeitstempel, die Spalte Temperature den gemessenen Wert. Wie Sensordaten per MQTT in eine Hub-Liste gelangen, erklärt der Artikel MQTT-Daten mit Peakboard Hub Flows historisieren. Für die Abfragen in diesem Beispiel muss TS im Format yyyy-MM-dd HH:mm:ss vorliegen und Temperature als Zahl.
Hub Flow für die Aggregation
Das Flow-Projekt enthält zwei Hub Flows. Der erste heißt AggregateTemperature und verdichtet die Rohdaten. Dafür sind vier Schritte nötig.
1. Hub-Liste für die Tageswerte
Die Hub-Liste TemperatureDaily nimmt die Tageswerte auf. Sie bekommt die Spalte Date vom Typ String sowie die Spalten MinTemp, MaxTemp und AvTemp vom Typ Number. Im Flow-Projekt kannst du anschließend eine Datenquelle für diese Liste anlegen, damit der Hub Flow später hineinschreiben kann.

2. Datenquelle mit SQL-Aggregation
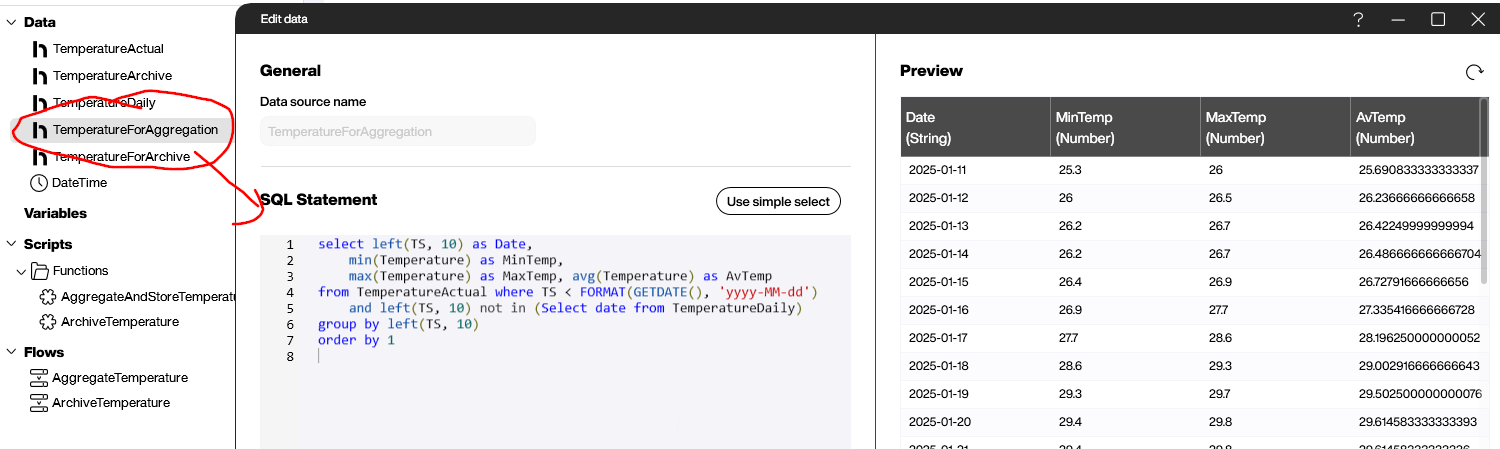
Die Datenquelle TemperatureForAggregation berechnet die Tageswerte mit diesem SQL-Statement:
select left(TS, 10) as Date,
    min(Temperature) as MinTemp,
    max(Temperature) as MaxTemp, avg(Temperature) as AvTemp
from TemperatureActual where TS < FORMAT(GETDATE(), 'yyyy-MM-dd')
    and left(TS, 10) not in (Select date from TemperatureDaily)
group by left(TS, 10)
order by 1
Die Bedingung im where sorgt für zwei Dinge: Der aktuelle Tag bleibt außen vor, weil seine Werte noch eingehen, und es kommen nur Tage dazu, die noch nicht in TemperatureDaily stehen. left(TS, 10) nimmt die ersten 10 Zeichen des Zeitstempels, also das Datum ohne Uhrzeit. Die Werte selbst berechnen die SQL-Funktionen min, max und avg.
3. Funktion zum Speichern
Die Funktion AggregateAndStoreTemperature kannst du mit Building Blocks bauen. Sie geht die Zeilen von TemperatureForAggregation in einer Schleife durch, schreibt jede als neue Zeile in die Hub-Liste TemperatureDaily und vermerkt das Datum im Log. Normalerweise ist das eine Zeile pro Tag. Fällt ein Tag aus, wird die fehlende Zeile am nächsten Tag nachgetragen.

4. Hub Flow mit Zeitplan
Ein zeitgesteuerter Trigger (Schedule) startet den Hub Flow AggregateTemperature jeden Tag um 23:00 Uhr. Im ersten Schritt lädt der Hub Flow die Datenquelle TemperatureForAggregation neu, im zweiten führt er die Funktion AggregateAndStoreTemperature aus.

Ist TemperatureDaily beim ersten Lauf noch leer, schreibt der Hub Flow alle fehlenden Zeilen der letzten 7 Tage nach, danach eine Zeile pro Tag.

Hub Flow für die Archivierung
Für das Archiv kannst du die Hub-Liste TemperatureArchive mit den Spalten TS und Temperature anlegen und dazu eine Datenquelle im Flow-Projekt, damit der Hub Flow hineinschreiben kann. Die Datenquelle TemperatureForArchive holt alle Zeilen aus TemperatureActual, die älter als 7 Tage und noch nicht im Archiv sind:
select * from TemperatureActual
where TS < FORMAT(GETDATE() - 7, 'yyyy-MM-dd')
    and TS not in (select TS from TemperatureArchive)
Die Funktion ArchiveTemperature geht jede dieser Zeilen durch und schreibt TS und Temperature in TemperatureArchive. Anschließend entfernt sie die Zeile über deren Spalte ID aus TemperatureActual.

Der zweite Hub Flow heißt wie die Funktion ArchiveTemperature. Er startet jeden Tag um 23:15 Uhr, also nach der Aggregation, lädt TemperatureForArchive neu und führt danach die Funktion aus.

Beide Muster kombinieren
Vorab aggregieren und archivieren kannst du einzeln oder gemeinsam einsetzen. Möglich ist auch, nach der Aggregation die zugehörigen Rohdaten zu entfernen. Sie sind dann endgültig gelöscht. Das bietet sich für Daten an, die nur kurzfristig relevant sind.
Die Beispiele im Video
Weiterführende Links
Das Flow-Projekt ArchiveAndAggregate.pbfx kannst du herunterladen und im Peakboard Designer öffnen. Einen weiteren Ansatz beschreibt der Artikel zum Data Historian mit Peakboard. Er erklärt, wie du Maschinenzustände in einer eigenen SQL-Datenbank speichern und auswerten kannst.
Produkt
Peakboard Hub Flows
Alle Funktionen, die Preise und die 60-tägige Testphase des Peakboard Hub stehen auf der Produktseite zu Peakboard Hub Flows.

Warum Sensordaten vorab aggregieren?
Viele Anwendungen brauchen nur verdichtete Werte wie Tagesminimum, -maximum und -durchschnitt. Ein Hub Flow berechnet sie einmal, und alle Anwendungen können das Ergebnis nutzen.
Wann laufen die Hub Flows im Beispiel?
Beide laufen einmal täglich mit einem zeitgesteuerten Trigger. Die Aggregation startet um 23:00 Uhr, die Archivierung um 23:15 Uhr.
Bleiben die Daten beim Archivieren erhalten?
Ja. Der Hub Flow schreibt jede Zeile zuerst in die Archivliste TemperatureArchive und entfernt sie erst danach aus der Rohdatenliste TemperatureActual. In TemperatureArchive bleiben die Daten verfügbar.
Wie fragt das Beispiel die Hub-Listen ab?
Mit SQL-Statements in den Datenquellen, zum Beispiel mit min, max und avg für die Tageswerte.
Welche Werte berechnet die Aggregation?
Minimum, Maximum und Durchschnitt der Temperatur pro Tag. Der Hub Flow schreibt sie in die Spalten MinTemp, MaxTemp und AvTemp der Hub-Liste TemperatureDaily. Der aktuelle Tag bleibt außen vor, weil seine Werte noch eingehen.